Почему пилот ИИ срывается и как убрать риски
Главный вывод: я вижу, что пилот ИИ чаще ломается не на модели, а на запуске процесса. Если до старта не зафиксировать _один сценарий_, _одного владельца_, _метрики_, _контур данных_ и _границы пилота_, команда почти всегда получает спор вместо результата.
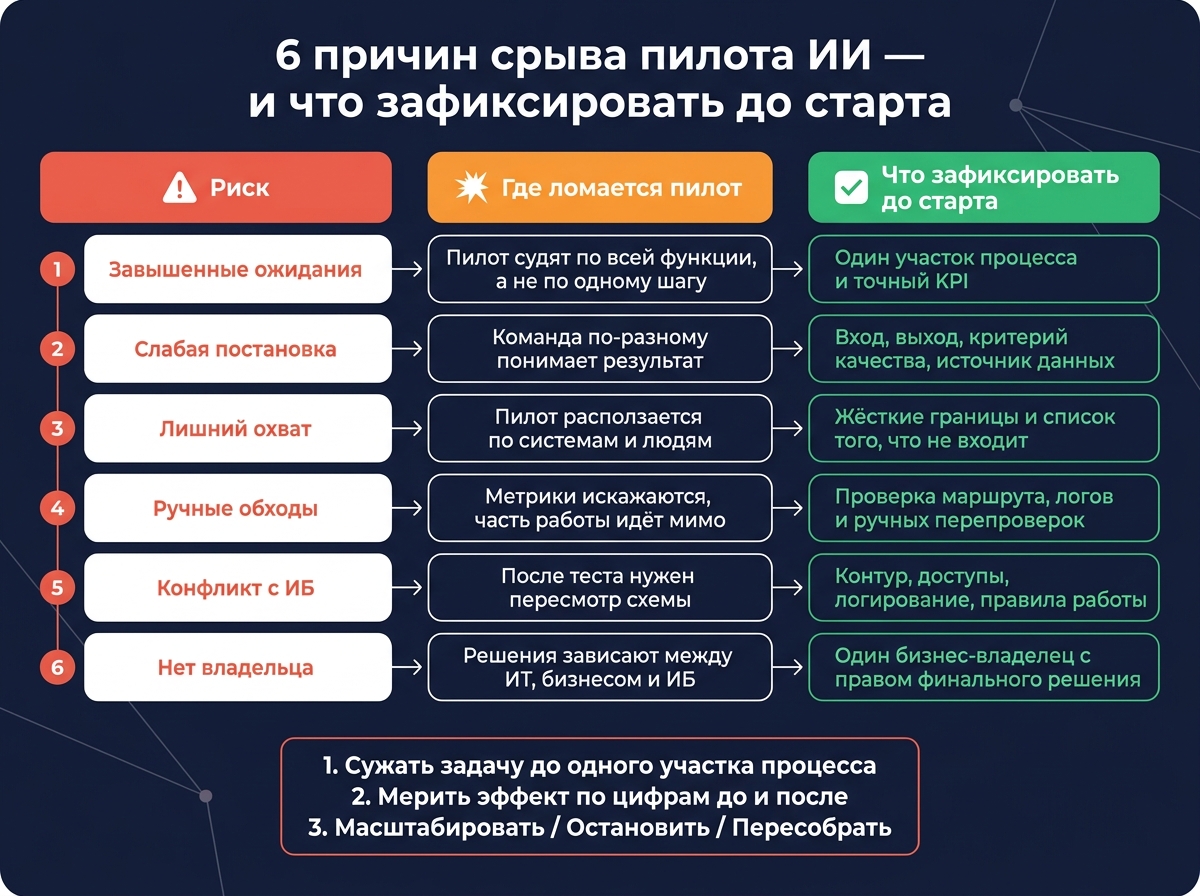
Если говорить совсем просто, в статье разобраны 6 причин срыва пилота и один общий способ их снять ещё до запуска:
- завышенные ожидания - от пилота ждут не один шаг, а починку всей функции;
- слабая постановка задачи - неясно, что на входе, что на выходе и как мерить качество;
- лишний охват - в пилот добавляют новые системы, команды и исключения;
- ручные обходы - сотрудники продолжают работать вне нового маршрута;
- конфликт с ИБ - безопасность подключают слишком поздно;
- нет владельца процесса - участвуют все, но решение не принимает никто.
Я бы свёл смысл статьи к трём правилам:
- Сужать задачу до одного участка процесса.
- Мерить эффект по цифрам до и после.
- Решать по итогам только одно из трёх: масштабировать, остановить или пересобрать.
Ниже - краткая сводка по всем шести рискам.
| Риск | Где ломается пилот | Что я бы зафиксировал до старта |
|---|---|---|
| Завышенные ожидания | Пилот судят по всей функции, а не по одному шагу | Один участок процесса и точный KPI |
| Слабая постановка | Команда по-разному понимает результат | Вход, выход, критерий качества, источник данных |
| Лишний охват | Пилот расползается по системам и людям | Жёсткие границы и список того, что не входит |
| Ручные обходы | Метрики искажаются, часть работы идёт мимо | Проверку маршрута, логов и ручных перепроверок |
| Конфликт с ИБ | После теста нужен пересмотр схемы | Контур, доступы, логирование, правила работы |
| Нет владельца | Решения зависают между ИТ, бизнесом и ИБ | Одного бизнес-владельца с правом финального решения |
Если у вас пилот ИИ уже идёт или только планируется, я бы начал именно с этого списка. Он даёт быстрый ответ: _что может сорвать запуск_ и _что нужно подготовить заранее_, чтобы не тратить недели впустую.
Паттерны срыва 1–2: завышенные ожидания и слабая постановка задачи
Завышенные ожидания: когда пилот должен «починить» целую функцию
Руководитель может утвердить пилот с формулировкой «автоматизировать один шаг в процессе продаж». Звучит просто. Но на деле от него часто ждут куда большего: что ИИ закроет весь контур - от квалификации лидов до подготовки КП и отчётности.
И вот тут начинается сбой.
Если ИИ нормально справляется с одной задачей, но не тянет всю функцию целиком, пилот нередко считают провальным. Хотя по факту технология могла хорошо отработать именно тот участок, для которого её запускали.
Проблема возникает в тот момент, когда пилоту ставят цель уровня всей функции, а не одного конкретного шага. Формулировка вроде «сэкономить время отдела» звучит красиво, но почти ничего не даёт для оценки. Без привязки к точному процессу и стартовым цифрам результат просто не с чем сравнивать.
Что помогает:
- зафиксировать базовую метрику до запуска;
- определить, сколько времени операция занимает сейчас;
- посчитать, какой процент задач теряется;
- отметить, сколько ошибок возникает за неделю.
После этого задают понятный порог успеха: пилот считается успешным, если он сокращает цикл выполнения конкретного шага до заранее заданного времени именно для этого шага. Отдельно задают критерий качества результата.
Именно это и даёт нормальную точку принятия решения: масштабировать или остановить. Не абстрактное «достигнут KPI», а ясный ответ по одному участку процесса.
ИИ становится частью процесса только тогда, когда он стабильно выполняет свой кусок работы снова и снова. Как только сценарий растягивают сразу на несколько шагов и систем, риск уходит в лишний охват.
Слабая постановка задачи: нет входа, выхода и критерия качества
Этот риск почти всегда идёт рядом с первым. Пилот запускают не от конкретной операции, а от общей идеи: «нужен ИИ». Вроде бы направление есть, но нет ответа на простые вопросы: что подаётся на вход, что должно получиться на выходе и по какому признаку результат считается правильным.
Дальше всё предсказуемо: уже в работе выясняется, что команда по-разному понимает успех.
До старта нужна карточка пилота. В ней фиксируют:
- боль;
- участок процесса;
- вход;
- выход;
- критерий качества;
- источник данных;
- владельца;
- ожидаемый эффект.
Такая рамка помогает снять риск слабой постановки ещё до того, как команда потратит время и деньги.
Слаживание строит диагностику и скоупинг пилота по этой схеме: сначала сценарий, данные и критерии, затем запуск.
Если пилот изначально задан слишком широко, дальше он почти неизбежно начинает расползаться по системам и исключениям.
Паттерны срыва 3–4: лишний охват и ручные обходы
Лишний охват: слишком много систем, команд и исключений в одном пилоте
Пилот часто начинается с одного сценария. Но потом в него добавляют интеграции, новые команды и частные исключения. В какой-то момент это уже не управляемый тест, а перегруженная конструкция, в которой сложно отделить рабочие решения от шума.
Из-за этого теряется измеримость. Уже неясно, что дало эффект, а что, наоборот, помешало. Пилот вроде бы идёт, но опираться на его результаты всё труднее.
Управленческое решение простое: один сценарий и жёсткие границы. Ещё до старта стоит отдельно зафиксировать, что пилот _не_ покрывает. Все новые запросы лучше не встраивать на ходу, а складывать в отдельный список для следующего этапа. Так пилот остаётся проверяемым, а его метрики - понятными.
Когда границы начинают плыть, команда почти неизбежно приходит к ручным обходам.
Ручные обходы: сотрудники продолжают работать по-старому
Даже при узком скоупе пилот может не сработать, если команда по факту живёт в старом процессе. После запуска часть операций всё равно уходит в личные чаты, неформальные договорённости и ручную перепроверку. Обычно это не саботаж. Люди просто держатся за привычный маршрут, пока новый порядок не стал нормой.
Проблема в том, что из-за этого искажаются метрики пилота. Часть операций проходит мимо системы, и решение о масштабировании принимают уже не на полной картине.
До запуска полезно описать процесс _as is_ и честно отметить:
- где данные уходят мимо системы
- где результат перепроверяют вручную
- где появляются обходные маршруты
После этого фиксируют точки, в которых человек всё ещё участвует в принятии решения, и делают новый процесс обязательным рабочим маршрутом. Дальше нужна простая, но жёсткая практика: после запуска сверять логи системы с фактическим движением данных и быстро закрывать найденные обходы.
Главная проблема здесь не в ручном действии как таковом. Проблема в другом: метрики пилота становятся недостоверными.
Если обходы не закрыты, следующим риском становится конфликт с ИБ.
Паттерны срыва 5–6: конфликт с ИБ и отсутствие владельца процесса
Конфликт с информационной безопасностью: пилот заблокирован после технического успеха
Когда все обходные пути уже закрыты, пилот часто упирается в два последних барьера: ИБ и право принять финальное решение.
Пилот может дать хороший результат, но застопориться на согласовании с ИБ. Обычно так бывает, когда безопасность подключают уже после разработки, а не в начале. В таком случае то, что выглядело рабочим на тесте, внезапно требует переделки. Особенно если архитектура завязана на публичные API или внешний контур клиента.
Проще говоря, ИБ нельзя подключать «на финише». Её нужно закладывать в саму задачу и в архитектуру ещё до запуска. До старта стоит сразу зафиксировать:
- контур работы
- какие данные разрешены
- уровни доступа
- правила логирования
- с каких корпоративных устройств можно работать
Для компаний с высокими требованиями к безопасности Слаживание поддерживает on-prem-развёртывание: данные остаются в контуре клиента, доступ разграничен по ролям, действия фиксируются в неизменяемом журнале.
Но даже если согласование с ИБ прошло успешно, пилот всё равно может сломаться. Причина уже в другом: у него нет одного ответственного.
Нет владельца процесса: все участвуют, никто не отвечает
Когда за пилот сразу отвечают ИТ, бизнес, инновационный блок и ИБ, проект быстро распадается на отдельные куски. Форматы данных не совпадают, решения зависают, а неформальные договорённости начинают подменять обычный процесс.
После согласования с ИБ следующий риск уже не технический, а управленческий. Здесь нужен один бизнес-владелец с реальными полномочиями. Именно он утверждает правила, KPI, исключения и решение о масштабировании.
Как снизить риски до запуска: модель управления пилотом
Эти риски лучше снять ещё до старта. Иначе потом придётся разбирать сбои на ходу, терять время и спорить о том, что вообще пошло не так. Поэтому до запуска стоит заранее зафиксировать контрольные точки.
Чеклист перед запуском пилота
Перед стартом пилота зафиксируйте контрольные точки. Каждый пункт в этом списке закрывает один из типовых рисков: завышенные ожидания, слабую постановку задачи, лишний охват, ручные обходы, конфликт с ИБ и ситуацию, когда у процесса просто нет одного ответственного.
| Контрольная точка | Что должно быть готово |
|---|---|
| Один процесс, один отдел | Чёткая граница охвата: без расширения на соседние функции |
| Базовые метрики | Зафиксированы текущие показатели и способ измерения эффекта |
| Критерии успеха | Понятно, какой результат сделает пилот успешным |
| Контур данных | Согласованы данные, доступ и контур работы |
| Финальное решение за человеком | Финальное решение остаётся за человеком |
| Владелец процесса | Назначен один владелец с полномочиями по KPI и правилам |
| Список доработок | Все запросы «а давайте ещё» отправлены в отдельный список, а не в текущий пилот |
Когда масштабировать, когда остановить, когда пересобрать
После пилота не стоит опираться на впечатления вроде «вроде стало лучше». Нужен прямой выбор из трёх вариантов. Откладывать решение - плохая идея.
Масштабировать можно только в одном случае: если KPI стал лучше и этот результат держится стабильно, пользователи приняли новый подход, ИБ финально согласовала контур данных, а сам процесс идёт через ИИ, а не мимо него. Здесь важен один момент: все условия должны выполняться сразу, а не по отдельности.
Остановить стоит тогда, когда за период пилота нет измеримого эффекта. Не на словах, не «по ощущениям», а по цифрам.
Пересобрать пилот нужно, если польза вроде бы есть, но сам запуск уткнулся в лишний охват, слабый контур данных или отсутствие владельца процесса. В такой ситуации лучше вернуться к планированию, сузить задачу и убрать лишнее, чем тянуть дальше запуск, который с самого начала собран неровно.
Слаживание помогает пройти этот путь: от диагностики процессов и поиска узких мест - через пилот в одном отделе с измерением эффекта - к операционным изменениям и масштабированию ИИ в компании.
FAQs
С чего начать пилот ИИ?
Начните с чёткой постановки задачи и сразу назначьте владельца процесса. Это простой шаг, но он часто снимает массу проблем: завышенные ожидания, лишний охват и споры с информационной безопасностью.
С самого начала стоит зафиксировать конкретную цель и понять, как именно ИИ войдёт в текущую работу сотрудников. Иначе всё быстро расползается: команда ждёт одного, бизнес - другого, а на практике никто не понимает, где и зачем использовать новый инструмент.
Как выбрать KPI для пилота?
KPI для пилота ИИ лучше выбирать по измеримому бизнес-результату, а не по числу запущенных процессов. Иначе легко попасть в ловушку: вроде бы всё работает, сценарии запущены, а пользы для бизнеса почти нет.
Метрики должны прямо отвечать на простой вопрос: пилот решает конкретную задачу или нет? И ещё один не менее важный вопрос: помогает ли он не допустить разрыва между ожиданиями и тем, что компания получает на деле?
Обычно есть смысл смотреть на показатели, которые связаны с такими вещами:
- сокращение времени на операции;
- качество и точность работы ИИ-агентов;
- уровень интеграции в CRM, 1С и почту;
- возможность масштабировать решение без потери эффективности.
Такой подход помогает оценивать пилот не по активности ради активности, а по тому, даёт ли он заметный рабочий эффект.
Когда нужно остановить пилот?
Пилот стоит остановить, если в текущем виде он срывается снова и снова, а причины нельзя быстро убрать.
Обычно это видно по таким сигналам:
- ожидания изначально завышены
- задача поставлена расплывчато
- охват слишком большой для пилота
- команда постоянно уходит в ручные обходы
- есть конфликт с ИБ
- у процесса нет владельца
Если говорить проще, пилот перестаёт быть проверкой гипотезы и превращается в источник лишней нагрузки. Команда тратит время, но не двигается к внятному результату. В такой точке пауза или остановка - нормальный рабочий шаг, а не провал.